

Cómo clasificar documentos con IA en tu empresa
21 de octubre, 2026
Una factura retenida en un correo, un contrato guardado con un nombre ambiguo o una orden de compra capturada dos veces pueden detener un proceso completo. El problema no es solo dónde se almacenan los archivos: es que la empresa no puede identificarlos, validarlos, dirigirlos y encontrarlos con la velocidad que exige su operación. Entender cómo clasificar documentos con IA permite convertir ese volumen desordenado en información operable, trazable y útil para tomar decisiones.
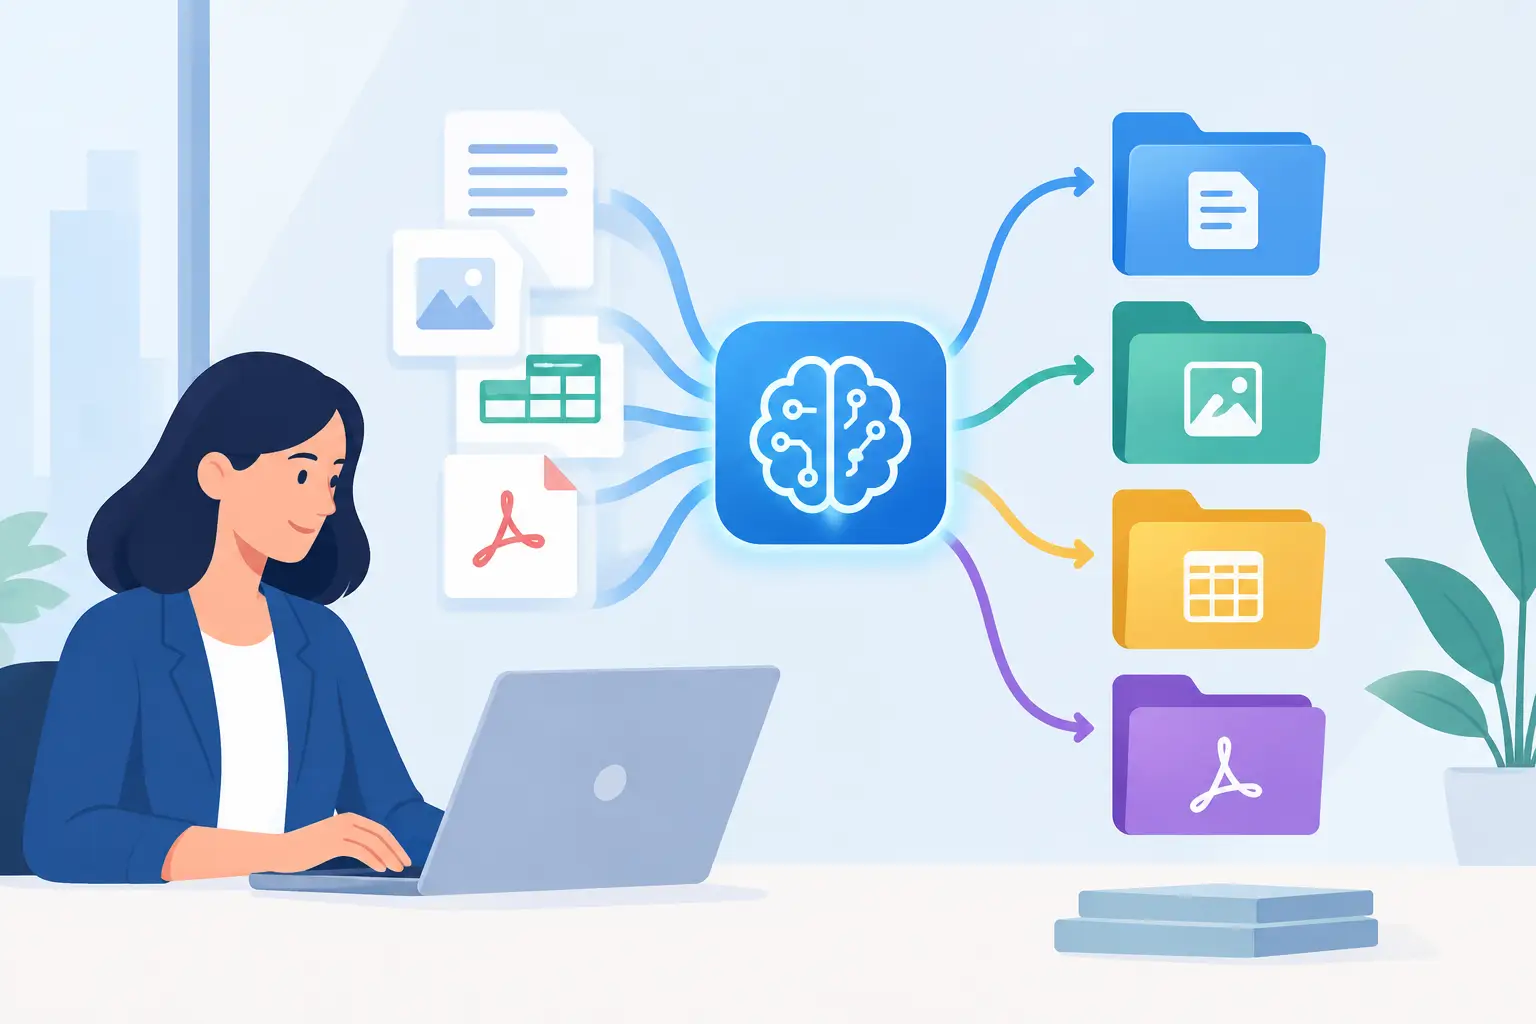
La inteligencia artificial no sustituye por sí sola una política documental ni corrige procesos inconsistentes. Sí puede leer documentos, extraer datos relevantes, reconocer su tipo, asignar prioridades y enviarlos al flujo correcto. Cuando se implementa sobre reglas de negocio claras e integrada con los sistemas de la empresa, reduce captura manual, errores y tiempos de respuesta.
Qué significa clasificar documentos con IA
Clasificar documentos consiste en determinar qué es cada archivo y qué debe ocurrir con él. Por ejemplo, distinguir entre una factura de proveedor, una cotización, un estado de cuenta, una solicitud de compra, un contrato laboral o un comprobante de entrega. A partir de esa clasificación, el sistema puede etiquetar el documento, extraer campos, asignarlo a un área, iniciar una aprobación o resguardarlo conforme a una política de conservación.
Con IA, este proceso deja de depender exclusivamente de que una persona abra cada archivo, lea su contenido y lo renombre. Los modelos pueden analizar texto digital, imágenes escaneadas y formatos variables mediante reconocimiento óptico de caracteres, procesamiento de lenguaje natural y modelos de visión. También pueden identificar patrones como RFC, fechas, montos, números de orden, nombres de proveedores, cláusulas contractuales o datos de clientes.
La diferencia relevante está en el contexto. Una fecha no tiene el mismo significado en todos los documentos, y un PDF con el logotipo de un proveedor no siempre es una factura. Por eso, una solución empresarial debe combinar la detección de información con reglas definidas por la operación: montos de autorización, centros de costo, tipos de gasto, vigencias, responsables y excepciones.
Cómo clasificar documentos con IA sin perder control
El punto de partida no es elegir una herramienta. Es identificar dónde se acumulan documentos, quién los recibe, qué decisiones dependen de ellos y qué errores cuestan más tiempo o dinero. En una empresa, la clasificación documental suele involucrar correo electrónico, carpetas compartidas, almacenamiento cloud, sistemas administrativos, ERP y portales de proveedores. Si el flujo no está definido, automatizarlo solo acelera el desorden.
1. Delimitar casos de uso con impacto operativo
Conviene comenzar por un proceso repetitivo, de alto volumen y con reglas relativamente claras. Cuentas por pagar es un caso frecuente: llegan facturas por varios canales, se revisan datos fiscales, se relacionan con órdenes de compra y se envían a validación. Otro caso es la gestión contractual, donde se requiere identificar tipo de contrato, contraparte, fecha de vencimiento y cláusulas que exigen revisión.
No todos los documentos deben automatizarse al mismo tiempo. Una póliza compleja o un contrato de alto riesgo puede requerir revisión humana obligatoria, aunque la IA extraiga y organice sus datos. En cambio, comprobantes recurrentes y solicitudes estandarizadas pueden procesarse con mayor automatización. La prioridad debe responder al costo del retrabajo, los tiempos de ciclo y el riesgo operativo, no a una demostración tecnológica.
2. Definir una taxonomía útil para el negocio
La taxonomía es el catálogo de categorías y atributos que utilizará la empresa. No basta con crear carpetas como “finanzas” o “legal”. Una clasificación útil puede distinguir documento, subproceso, proveedor, unidad de negocio, estatus, nivel de confidencialidad y periodo de retención.
Para una factura, los campos pueden incluir proveedor, RFC, folio fiscal, fecha, monto, moneda, orden de compra, centro de costo y estatus de validación. Para un contrato, puede ser necesario registrar parte contratante, vigencia, renovación automática, obligación clave, responsable interno y nivel de riesgo. Esta estructura permite buscar, reportar y auditar después.
La regla es simple: cada campo debe servir para ejecutar una decisión, cumplir una obligación o responder una consulta recurrente. Pedir datos que nadie utilizará añade complejidad y baja la calidad del proceso.
3. Preparar fuentes documentales y datos históricos
La IA aprende de ejemplos y opera mejor cuando recibe documentos representativos de la realidad de la empresa. Se deben reunir archivos de distintos proveedores, periodos, formatos y niveles de calidad. También es necesario detectar duplicados, archivos ilegibles, categorías mal nombradas y documentos que contienen información sensible.
Los datos históricos ayudan a configurar criterios de clasificación y validación. Si una empresa cuenta con facturas previamente aprobadas, contratos etiquetados o solicitudes resueltas, puede utilizarlos para evaluar si el sistema identifica correctamente los campos esperados. Aun así, los documentos históricos no deben asumirse como verdad absoluta: muchas organizaciones arrastran errores de captura y criterios distintos entre áreas.
4. Combinar IA, reglas de negocio y revisión humana
Una implementación confiable no deja decisiones críticas a una predicción sin supervisión. La IA puede indicar que un archivo tiene alta probabilidad de ser una factura y extraer un monto, pero las reglas de negocio determinan si ese monto coincide con la orden de compra, si requiere autorización adicional o si debe detenerse por una discrepancia.
También se necesita un umbral de confianza. Si el sistema reconoce un documento con alta certeza, puede clasificarlo y enviarlo al flujo correspondiente. Si detecta información incompleta, baja confianza o una excepción, debe escalarlo a una persona con el contexto adecuado. Esto reduce trabajo repetitivo sin perder control sobre pagos, obligaciones legales o información confidencial.
La arquitectura que vuelve operable la clasificación
La clasificación documental no termina cuando un modelo devuelve una etiqueta. El valor aparece cuando esa información llega al sistema correcto y deja evidencia de cada decisión. Una arquitectura funcional normalmente conecta cuatro capas: recepción de documentos, procesamiento y extracción, reglas y flujos, y almacenamiento con trazabilidad.
Los archivos pueden entrar desde correo, portales, escáneres, aplicaciones móviles o carpetas controladas. Después, el motor de procesamiento lee el contenido, identifica el tipo de documento y extrae los datos requeridos. La capa de reglas valida formatos, compara información contra catálogos o transacciones del ERP y define rutas de aprobación. Finalmente, el documento y sus metadatos se resguardan con permisos, historial y criterios de conservación.
La integración con ERP, CRM, software contable o plataformas internas es determinante. Si la factura se clasifica correctamente pero alguien debe volver a capturar sus datos en el sistema financiero, el proceso continúa fragmentado. En cambio, si se relaciona con una orden de compra, un proveedor y una cuenta por pagar desde el inicio, la empresa obtiene continuidad operativa y mejor visibilidad.
La seguridad también debe diseñarse desde el principio. Los documentos pueden contener datos personales, información financiera, precios negociados, expedientes laborales o propiedad intelectual. Se requieren controles de acceso por rol, cifrado, registros de actividad, políticas de retención y mecanismos para evitar que información sensible se procese o comparta fuera de los criterios autorizados. La solución correcta depende de las obligaciones regulatorias, la industria y la política interna de cada empresa.
Cómo medir si la IA está generando resultados
Una clasificación rápida que produce errores no es una mejora. Los indicadores deben medir eficiencia y calidad al mismo tiempo. El tiempo promedio desde la recepción hasta la disponibilidad del documento muestra si el flujo eliminó esperas. El porcentaje de documentos procesados sin intervención refleja el nivel de automatización real. La precisión de clasificación y extracción revela si los datos pueden utilizarse con confianza.
También conviene medir excepciones, documentos duplicados, devoluciones por datos incompletos y cumplimiento de acuerdos internos de servicio. En cuentas por pagar, por ejemplo, el resultado puede observarse en menos facturas extraviadas, menor tiempo de aprobación y menos pagos duplicados. En contratos, puede reflejarse en alertas oportunas de vencimiento y reducción de riesgos por renovaciones no atendidas.
Estos indicadores deben revisarse por área y tipo documental. Un promedio general puede ocultar que las facturas se procesan bien mientras los documentos de proveedores nuevos generan errores constantes. La mejora continua depende de analizar esas excepciones, ajustar reglas y ampliar el conjunto de ejemplos cuando cambian los formatos o las políticas.
Errores que limitan el proyecto
El error más común es tratar la clasificación como una compra de software aislada. Sin una definición de categorías, responsables y excepciones, el resultado será una nueva bandeja de pendientes. Otro problema es buscar automatización total desde el primer día. Es más efectivo iniciar con un flujo delimitado, validar resultados y escalar con aprendizaje operativo.
Tampoco conviene confiar ciegamente en documentos digitales. Un PDF puede ser una imagen escaneada, contener páginas mezcladas o traer datos visualmente parecidos pero incorrectos. Por esa razón, las validaciones contra catálogos, órdenes, montos y políticas internas son tan relevantes como la extracción de texto.
Finalmente, no se debe ignorar la adopción. Las personas que reciben, validan y autorizan documentos conocen las excepciones que rara vez aparecen en un diagrama. Involucrarlas desde el diagnóstico permite construir una solución que reduzca fricción en lugar de imponer pasos adicionales.
Una estrategia bien ejecutada convierte el archivo documental en una fuente de control, no en una carga administrativa. Odisys parte de los flujos, las reglas y los sistemas que ya sostienen la operación para diseñar automatización con IA que pueda medirse, gobernarse y evolucionar. El siguiente paso útil es mapear un proceso documental específico, identificar sus excepciones y calcular cuánto cuesta hoy que la información llegue tarde, incompleta o al responsable equivocado.